
Denoising Diffusion Probabilistic Models

1. 我们到底想解决什么问题​

训练集中有许多真实图片,它们来自某个未知的数据分布:

x∼pdata(x).x\sim p_{\mathrm{data}}(x).

我们希望训练一个生成模型 pθ(x)p_\theta(x),使它生成的图片也像是来自真实数据分布。这里 θ\theta 表示模型中所有需要通过训练学习的参数;下标 θ\theta 表示这个概率分布会随着模型参数改变。

“两个分布尽可能接近”可以写成最小化:

DKL(pdata∥pθ)=Epdata[log⁡pdata(x)pθ(x)].D_{\mathrm{KL}}\left(p_{\mathrm{data}}\|p_\theta\right) = \mathbb E_{p_{\mathrm{data}}} \left[ \log \frac{p_{\mathrm{data}}(x)}{p_\theta(x)} \right].

将它拆开:

DKL(pdata∥pθ)=Epdata[log⁡pdata(x)]⏟与 θ 无关−Epdata[log⁡pθ(x)].D_{\mathrm{KL}}(p_{\mathrm{data}}\|p_\theta) = \underbrace{ \mathbb E_{p_{\mathrm{data}}}[\log p_{\mathrm{data}}(x)] }_{\text{与 }\theta\text{ 无关}} - \mathbb E_{p_{\mathrm{data}}}[\log p_\theta(x)].

因此,最小化两个分布之间的 KL,等价于最大化真实图片在模型下的对数似然:

max⁡θEx∼pdata[log⁡pθ(x)].\max_\theta \mathbb E_{x\sim p_{\mathrm{data}}} [\log p_\theta(x)].

训练集中只有有限张图片,所以实际优化的是样本平均:

max⁡θ1N∑n=1Nlog⁡pθ(x(n)).\max_\theta \frac{1}{N} \sum_{n=1}^{N} \log p_\theta(x^{(n)}).

到这里,DDPM 与 VAE 的出发点完全一样:

让模型给真实图片分配更高的概率。

2. 直接学习图片分布困难​

一张图片可能包含物体、纹理、姿态、光照和背景等复杂结构。让神经网络直接写出并计算 pθ(x)p_\theta(x) 很困难。

但有一件事情非常容易:把一张图片逐渐破坏成高斯噪声。

如果我们能构造下面这条过程:

真实图片⟶略带噪声的图片⟶⋯⟶高斯噪声,\text{真实图片} \longrightarrow \text{略带噪声的图片} \longrightarrow \cdots \longrightarrow \text{高斯噪声},

那么生成就可以考虑走相反的方向:

高斯噪声⟶⋯⟶清晰图片.\text{高斯噪声} \longrightarrow \cdots \longrightarrow \text{清晰图片}.

从标准高斯中采样很容易。于是原来的难题被改写为:

能否学习许多个简单的“小步去噪”,最终把高斯噪声变成真实图片?

这就是扩散模型的核心思路。

然后具体的实现是预测噪声 然后带噪声的图减去噪声 多个时间步后完成图片生成
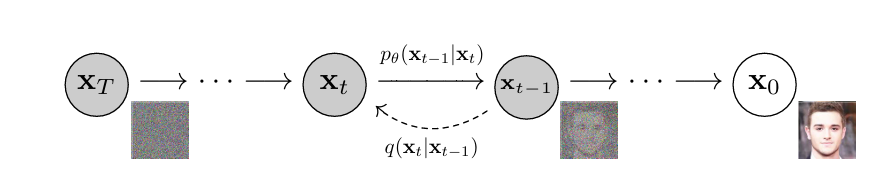
DDPM 前向加噪与反向生成链

3. 把图片逐步变成噪声​

3.1 变量定义​

现在把训练图片记作 x0x_0。下标表示噪声时间:x0x_0 是干净图片,xtx_t 是经过 tt 次加噪后的图片。

第 tt 步的前向加噪定义为:

q(xt∣xt−1)=N(xt;1−βt xt−1,βtI).q(x_t\mid x_{t-1}) = \mathcal N \left( x_t; \sqrt{1-\beta_t}\,x_{t-1}, \beta_t I \right).

式中:

  • qq 表示人为规定的前向加噪过程,它没有可学习参数;
  • q(xt∣xt−1)q(x_t\mid x_{t-1}) 表示在给定 xt−1x_{t-1} 后,xtx_t 的条件概率分布;
  • N(x;μ,Σ)\mathcal N(x;\mu,\Sigma) 表示变量 xx 服从均值为 μ\mu、协方差为 Σ\Sigma 的高斯分布;
  • II 是单位矩阵,因此 βtI\beta_t I 表示各维噪声方差都是 βt\beta_t,并且不同维度之间不相关。

βt\beta_t 表示这一步加入多少噪声,通常是一个很小的正数。对应的采样过程是:

xt=1−βt xt−1+βt zt,zt∼N(0,I).x_t = \sqrt{1-\beta_t}\,x_{t-1} + \sqrt{\beta_t}\,z_t, \qquad z_t\sim\mathcal N(0,I).

这一步同时做了两件事:

  1. 用 1−βt\sqrt{1-\beta_t} 稍微缩小原有信号;
  2. 加入方差为 βt\beta_t 的新高斯噪声。

为了让后续公式更简洁,这时再定义:

αt=1−βt,αˉt=∏s=1tαs.\alpha_t=1-\beta_t, \qquad \bar\alpha_t=\prod_{s=1}^{t}\alpha_s.

αt\alpha_t 是单步信号保留比例,αˉt\bar\alpha_t 是从 x0x_0 到 xtx_t 的累计信号保留比例。

3.2 难道训练时要一步一步加噪吗​

如果每次训练都必须计算:

x0→x1→⋯→xt,x_0\to x_1\to\cdots\to x_t,

代价会很高。连续的线性高斯变换可以合并,因此我们可以直接得到任意时刻 tt 的条件分布:

q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I).q(x_t\mid x_0) = \mathcal N \left( x_t; \sqrt{\bar\alpha_t}x_0, (1-\bar\alpha_t)I \right).

它对应的一步采样公式是:

xt=αˉtx0+1−αˉt ϵ,ϵ∼N(0,I).x_t = \sqrt{\bar\alpha_t}x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon, \qquad \epsilon\sim\mathcal N(0,I).
展开证明:为什么多步加噪可以合并成这一个公式?

前向过程的单步采样公式是:

xt=αtxt−1+1−αt zt,zt∼N(0,I).x_t = \sqrt{\alpha_t}x_{t-1} + \sqrt{1-\alpha_t}\,z_t, \qquad z_t\sim\mathcal N(0,I).

先看前两步:

x1=α1x0+1−α1 z1.x_1 = \sqrt{\alpha_1}x_0 + \sqrt{1-\alpha_1}\,z_1.

将 x1x_1 代入第二步:

x2=α2x1+1−α2 z2=α2(α1x0+1−α1 z1)+1−α2 z2=α1α2 x0+α2(1−α1) z1+1−α2 z2.\begin{aligned} x_2 &= \sqrt{\alpha_2}x_1 + \sqrt{1-\alpha_2}\,z_2\\ &= \sqrt{\alpha_2} \left( \sqrt{\alpha_1}x_0 + \sqrt{1-\alpha_1}\,z_1 \right) + \sqrt{1-\alpha_2}\,z_2\\ &= \sqrt{\alpha_1\alpha_2}\,x_0 + \sqrt{\alpha_2(1-\alpha_1)}\,z_1 + \sqrt{1-\alpha_2}\,z_2. \end{aligned}

信号部分的系数已经变成:

α1α2=αˉ2.\sqrt{\alpha_1\alpha_2} = \sqrt{\bar\alpha_2}.

再看噪声部分。由于 z1,z2z_1,z_2 相互独立,且都服从 N(0,I)\mathcal N(0,I),它们的线性组合仍然是均值为 00 的高斯。

这里用到了“独立随机变量线性组合的方差可以相加”。这个结论可以直接由协方差的定义证明。

设两个随机向量为 X,YX,Y,令:

U=aX+bY.U=aX+bY.

根据协方差矩阵的定义:

Cov⁡(U)=E[(U−E[U])(U−E[U])T].\operatorname{Cov}(U) = \mathbb E \left[ (U-\mathbb E[U]) (U-\mathbb E[U])^\mathsf T \right].

将 U=aX+bYU=aX+bY 展开:

Cov⁡(aX+bY)=  a2Cov⁡(X)+b2Cov⁡(Y)+abCov⁡(X,Y)+abCov⁡(Y,X).\begin{aligned} \operatorname{Cov}(aX+bY) =&\; a^2\operatorname{Cov}(X) + b^2\operatorname{Cov}(Y)\\ &+ ab\operatorname{Cov}(X,Y) + ab\operatorname{Cov}(Y,X). \end{aligned}

其中交叉协方差为:

Cov⁡(X,Y)=E[(X−E[X])(Y−E[Y])T].\operatorname{Cov}(X,Y) = \mathbb E \left[ (X-\mathbb E[X]) (Y-\mathbb E[Y])^\mathsf T \right].

如果 XX 与 YY 相互独立,那么:

Cov⁡(X,Y)=E[X−E[X]] E[Y−E[Y]]T=0.\begin{aligned} \operatorname{Cov}(X,Y) &= \mathbb E[X-\mathbb E[X]] \, \mathbb E[Y-\mathbb E[Y]]^\mathsf T\\ &=0. \end{aligned}

同理 Cov⁡(Y,X)=0\operatorname{Cov}(Y,X)=0,所以:

Cov⁡(aX+bY)=a2Cov⁡(X)+b2Cov⁡(Y).\operatorname{Cov}(aX+bY) = a^2\operatorname{Cov}(X) + b^2\operatorname{Cov}(Y).

注意,相加的是乘完系数后的方差 a2Cov⁡(X)a^2\operatorname{Cov}(X) 和 b2Cov⁡(Y)b^2\operatorname{Cov}(Y),不是把标准差 a,ba,b 直接相加。

回到 x2x_2 的噪声部分,取:

a=α2(1−α1),b=1−α2.a=\sqrt{\alpha_2(1-\alpha_1)}, \qquad b=\sqrt{1-\alpha_2}.

又因为:

Cov⁡(z1)=Cov⁡(z2)=I,\operatorname{Cov}(z_1) = \operatorname{Cov}(z_2) =I,

所以这两个噪声的协方差为:

α2(1−α1)I+(1−α2)I=(α2−α1α2+1−α2)I=(1−α1α2)I=(1−αˉ2)I.\begin{aligned} &\alpha_2(1-\alpha_1)I + (1-\alpha_2)I\\ &= \left( \alpha_2-\alpha_1\alpha_2+1-\alpha_2 \right)I\\ &= (1-\alpha_1\alpha_2)I = (1-\bar\alpha_2)I. \end{aligned}

所以可以用一份新的标准高斯噪声 ϵ∼N(0,I)\epsilon\sim\mathcal N(0,I) 表示整个噪声部分:

α2(1−α1) z1+1−α2 z2=1−αˉ2 ϵ.\sqrt{\alpha_2(1-\alpha_1)}\,z_1 + \sqrt{1-\alpha_2}\,z_2 = \sqrt{1-\bar\alpha_2}\,\epsilon.

于是:

x2=αˉ2x0+1−αˉ2 ϵ.x_2 = \sqrt{\bar\alpha_2}x_0 + \sqrt{1-\bar\alpha_2}\,\epsilon.

下面证明一般的第 tt 步。假设第 t−1t-1 步已经能够写成:

xt−1=αˉt−1x0+1−αˉt−1 ϵt−1,ϵt−1∼N(0,I).x_{t-1} = \sqrt{\bar\alpha_{t-1}}x_0 + \sqrt{1-\bar\alpha_{t-1}}\,\epsilon_{t-1}, \qquad \epsilon_{t-1}\sim\mathcal N(0,I).

把它代入第 tt 步:

xt=αtxt−1+1−αt zt=αtαˉt−1x0+αt(1−αˉt−1) ϵt−1+1−αt zt.\begin{aligned} x_t &= \sqrt{\alpha_t}x_{t-1} + \sqrt{1-\alpha_t}\,z_t\\ &= \sqrt{\alpha_t\bar\alpha_{t-1}}x_0\\ &\quad+ \sqrt{\alpha_t(1-\bar\alpha_{t-1})}\, \epsilon_{t-1} + \sqrt{1-\alpha_t}\,z_t. \end{aligned}

根据 αˉt=αtαˉt−1\bar\alpha_t=\alpha_t\bar\alpha_{t-1},信号部分就是:

αtαˉt−1x0=αˉtx0.\sqrt{\alpha_t\bar\alpha_{t-1}}x_0 = \sqrt{\bar\alpha_t}x_0.

后面两个独立高斯噪声的协方差之和为:

αt(1−αˉt−1)I+(1−αt)I=(1−αtαˉt−1)I=(1−αˉt)I.\begin{aligned} &\alpha_t(1-\bar\alpha_{t-1})I + (1-\alpha_t)I\\ &= \left( 1-\alpha_t\bar\alpha_{t-1} \right)I\\ &= (1-\bar\alpha_t)I. \end{aligned}

所以它们也能合并成一份新的标准高斯噪声:

αt(1−αˉt−1) ϵt−1+1−αt zt=1−αˉt ϵ.\sqrt{\alpha_t(1-\bar\alpha_{t-1})}\, \epsilon_{t-1} + \sqrt{1-\alpha_t}\,z_t = \sqrt{1-\bar\alpha_t}\,\epsilon.

最终得到:

xt=αˉtx0+1−αˉt ϵ,ϵ∼N(0,I).x_t = \sqrt{\bar\alpha_t}x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon, \qquad \epsilon\sim\mathcal N(0,I).

因此:

q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I).q(x_t\mid x_0) = \mathcal N \left( x_t; \sqrt{\bar\alpha_t}x_0, (1-\bar\alpha_t)I \right).

随着 tt 增大,αˉt\bar\alpha_t 越来越小:

  • x0x_0 的系数逐渐趋近于 00;
  • 噪声的系数逐渐趋近于 11;
  • 最终 xTx_T 近似服从 N(0,I)\mathcal N(0,I)。

前向过程 qq 是人为规定的,不需要训练。

4. 生成图片需要学习什么​

4.1 形式化​

前向加噪容易计算,但我们的目标是生成,所以需要沿相反方向运行:

xT→xT−1→⋯→x0.x_T\to x_{T-1}\to\cdots\to x_0.

生成过程从:

xT∼p(xT)=N(0,I)x_T\sim p(x_T)=\mathcal N(0,I)

开始,然后反复使用一个可学习的条件分布:

pθ(xt−1∣xt).p_\theta(x_{t-1}\mid x_t).

当每一步噪声 βt\beta_t 足够小时,反向的一小步也可以用高斯近似:

pθ(xt−1∣xt)=N(xt−1;μθ(xt,t),Σθ(xt,t)).p_\theta(x_{t-1}\mid x_t) = \mathcal N \left( x_{t-1}; \mu_\theta(x_t,t), \Sigma_\theta(x_t,t) \right).

式中每个符号的含义是:

  • pθp_\theta:需要训练的反向生成模型;
  • θ\theta:去噪网络的所有可学习参数;
  • μ\mu:希腊字母 mu,表示高斯分布的均值;
  • μθ(xt,t)\mu_\theta(x_t,t):由模型参数 θ\theta 决定的均值函数。它接收当前带噪图片 xtx_t 和时间步 tt,返回一个与 xtx_t 形状相同的向量;
  • Σ\Sigma:希腊字母 Sigma,表示高斯分布的协方差矩阵;
  • Σθ(xt,t)\Sigma_\theta(x_t,t):反向一步的不确定性;它决定从均值附近采样时可以偏离多远;
  • 下标 θ\theta:表示这个量由模型参数决定,并不是新的时间下标;
  • 分号前的 xt−1x_{t-1}:表示这个高斯分布所描述的随机变量;
  • 分号后的两项:依次是该高斯分布的均值和协方差。

所以这条公式可以直接读成:

给定 xtx_t,模型认为 xt−1x_{t-1} 服从一个高斯分布;该分布的均值是 μθ(xt,t)\mu_\theta(x_t,t),协方差是 Σθ(xt,t)\Sigma_\theta(x_t,t)。

这句话不是说 xt−1x_{t-1} 是一个固定答案,而是说:给定当前带噪图片 xtx_t,上一步较清晰的图片 xt−1x_{t-1} 仍有多种可能,DDPM 用一个高斯分布描述这些可能性。

  • 均值 μθ(xt,t)\mu_\theta(x_t,t) 表示 xt−1x_{t-1} 最可能位于哪里,也就是主要的去噪方向;
  • 协方差 Σθ(xt,t)\Sigma_\theta(x_t,t) 表示这一步还保留多少不确定性。

μθ\mu_\theta 是反向模型最终需要得到的均值参数,但在原始 DDPM 的常用实现中,U-Net 并不直接输出 μθ\mu_\theta。网络真正输出的是噪声预测:

ϵθ(xt,t).\epsilon_\theta(x_t,t).

4.2 真正不能直接求的是什么​

这里必须区分真实反向分布和模型反向分布:

q(xt−1∣xt)⏟真实反向分布,无法直接计算pθ(xt−1∣xt)⏟模型给出的高斯近似,可以计算和采样.\underbrace{q(x_{t-1}\mid x_t)}_{\text{真实反向分布,无法直接计算}} \qquad \underbrace{p_\theta(x_{t-1}\mid x_t)}_{\text{模型给出的高斯近似,可以计算和采样}}.

无法直接处理的不是 pθ(xt−1∣xt)p_\theta(x_{t-1}\mid x_t),而是 q(xt−1∣xt)q(x_{t-1}\mid x_t)。根据 Bayes 公式:

q(xt−1∣xt)=q(xt∣xt−1)q(xt−1)q(xt).q(x_{t-1}\mid x_t) = \frac{ q(x_t\mid x_{t-1})q(x_{t-1}) }{ q(x_t) }.

其中分母还可以写成:

q(xt)=∫q(xt∣xt−1)q(xt−1) dxt−1.q(x_t) = \int q(x_t\mid x_{t-1}) q(x_{t-1}) \,dx_{t-1}.

逐项来看:

  • q(xt∣xt−1)q(x_t\mid x_{t-1}):已知,因为它就是我们规定的单步高斯加噪过程;
  • q(xt−1)q(x_{t-1}):无法直接求,因为它是所有真实图片经过 t−1t-1 步加噪后的边缘分布;
  • q(xt)q(x_t):无法直接求,因为它需要对所有可能的 xt−1x_{t-1} 做积分。

4.3 加上 x0x_0 后可以求​

训练时,干净图片 x0x_0 是已知的。加上这个条件后,可以计算:

q(xt−1∣xt,x0)=q(xt∣xt−1,x0)q(xt−1∣x0)q(xt∣x0).q(x_{t-1}\mid x_t,x_0) = \frac{ q(x_t\mid x_{t-1},x_0) q(x_{t-1}\mid x_0) }{ q(x_t\mid x_0) }.

由于前向过程满足马尔可夫性,一旦知道 xt−1x_{t-1},xtx_t 就不再依赖 x0x_0,所以:

q(xt∣xt−1,x0)=q(xt∣xt−1).q(x_t\mid x_{t-1},x_0) = q(x_t\mid x_{t-1}).

因此:

q(xt−1∣xt,x0)=q(xt∣xt−1)q(xt−1∣x0)q(xt∣x0).q(x_{t-1}\mid x_t,x_0) = \frac{ q(x_t\mid x_{t-1}) q(x_{t-1}\mid x_0) }{ q(x_t\mid x_0) }.

右边三个分布都能由前向加噪公式直接得到,并且都是高斯分布,所以 q(xt−1∣xt,x0)q(x_{t-1}\mid x_t,x_0) 可以解析计算。

训练的目标就是让模型分布:

pθ(xt−1∣xt)p_\theta(x_{t-1}\mid x_t)

逼近这个可计算的真实后验:

q(xt−1∣xt,x0).q(x_{t-1}\mid x_t,x_0).

经过计算,最终得到:

q(xt−1∣xt,x0)=N(xt−1;μ~t(xt,x0),β~tI),q(x_{t-1}\mid x_t,x_0) = \mathcal N \left( x_{t-1}; \tilde\mu_t(x_t,x_0), \tilde\beta_t I \right),

其中:

β~t=1−αˉt−11−αˉtβt,\tilde\beta_t = \frac{1-\bar\alpha_{t-1}} {1-\bar\alpha_t} \beta_t, μ~t(xt,x0)=αˉt−1βt1−αˉtx0+αt(1−αˉt−1)1−αˉtxt.\tilde\mu_t(x_t,x_0) = \frac{ \sqrt{\bar\alpha_{t-1}}\beta_t }{ 1-\bar\alpha_t }x_0 + \frac{ \sqrt{\alpha_t}(1-\bar\alpha_{t-1}) }{ 1-\bar\alpha_t }x_t.
展开计算:代入三个高斯分布并完成配方

首先写出正确的 Bayes 公式:

q(xt−1∣xt,x0)=q(xt∣xt−1,x0)q(xt−1∣x0)q(xt∣x0).q(x_{t-1}\mid x_t,x_0) = \frac{ q(x_t\mid x_{t-1},x_0) q(x_{t-1}\mid x_0) }{ q(x_t\mid x_0) }.

由前向过程的马尔可夫性:

q(xt∣xt−1,x0)=q(xt∣xt−1).q(x_t\mid x_{t-1},x_0) = q(x_t\mid x_{t-1}).

所以:

q(xt−1∣xt,x0)=q(xt∣xt−1)q(xt−1∣x0)q(xt∣x0).q(x_{t-1}\mid x_t,x_0) = \frac{ q(x_t\mid x_{t-1}) q(x_{t-1}\mid x_0) }{ q(x_t\mid x_0) }.

这里要代入三个已知的高斯分布。

第一项是单步前向加噪:

q(xt∣xt−1)=N(xt;αtxt−1,βtI).q(x_t\mid x_{t-1}) = \mathcal N \left( x_t; \sqrt{\alpha_t}x_{t-1}, \beta_t I \right).

第二项是从 x0x_0 直接加噪到 xt−1x_{t-1}:

q(xt−1∣x0)=N(xt−1;αˉt−1x0,(1−αˉt−1)I).q(x_{t-1}\mid x_0) = \mathcal N \left( x_{t-1}; \sqrt{\bar\alpha_{t-1}}x_0, (1-\bar\alpha_{t-1})I \right).

第三项是从 x0x_0 直接加噪到 xtx_t:

q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I).q(x_t\mid x_0) = \mathcal N \left( x_t; \sqrt{\bar\alpha_t}x_0, (1-\bar\alpha_t)I \right).

将三个高斯直接代入 Bayes 公式,并使用 βt=1−αt\beta_t=1-\alpha_t,得到与图中式 (72) 相同的形式:

q(xt−1∣xt,x0)=N ⁣(xt;αtxt−1,(1−αt)I)N ⁣(xt−1;αˉt−1x0,(1−αˉt−1)I)N ⁣(xt;αˉtx0,(1−αˉt)I).\begin{aligned} q(x_{t-1}\mid x_t,x_0) = \frac{ \mathcal N\!\left( x_t;\sqrt{\alpha_t}x_{t-1},(1-\alpha_t)I \right) \mathcal N\!\left( x_{t-1};\sqrt{\bar\alpha_{t-1}}x_0, (1-\bar\alpha_{t-1})I \right) }{ \mathcal N\!\left( x_t;\sqrt{\bar\alpha_t}x_0, (1-\bar\alpha_t)I \right) }. \end{aligned}

把高斯密度写成指数形式,便得到图中的式 (73):

q(xt−1∣xt,x0)∝exp⁡{−12[∥xt−αtxt−1∥21−αt+∥xt−1−αˉt−1x0∥21−αˉt−1−∥xt−αˉtx0∥21−αˉt]}.\begin{aligned} q(x_{t-1}\mid x_t,x_0) \propto \exp\Bigg\{ -\frac{1}{2}\Bigg[ &\frac{ \|x_t-\sqrt{\alpha_t}x_{t-1}\|^2 }{ 1-\alpha_t }\\ &+ \frac{ \|x_{t-1}-\sqrt{\bar\alpha_{t-1}}x_0\|^2 }{ 1-\bar\alpha_{t-1} }\\ &- \frac{ \|x_t-\sqrt{\bar\alpha_t}x_0\|^2 }{ 1-\bar\alpha_t } \Bigg] \Bigg\}. \end{aligned}

第三项来自分母 q(xt∣x0)q(x_t\mid x_0)。它只包含已经给定的 xt,x0x_t,x_0,不包含待求随机变量 xt−1x_{t-1},所以官方推导在下一步把它记入常数 C(xt,x0)C(x_t,x_0)。

因此,在求关于 xt−1x_{t-1} 的分布形状时,可以去掉第三项以及其他与 xt−1x_{t-1} 无关的归一化常数:

q(xt−1∣xt,x0)∝q(xt∣xt−1)q(xt−1∣x0)∝exp⁡[−12(∥xt−αtxt−1∥2βt+∥xt−1−αˉt−1x0∥21−αˉt−1)].\begin{aligned} q(x_{t-1}\mid x_t,x_0) &\propto q(x_t\mid x_{t-1}) q(x_{t-1}\mid x_0)\\ &\propto \exp \left[ -\frac{1}{2} \left( \frac{ \|x_t-\sqrt{\alpha_t}x_{t-1}\|^2 }{\beta_t} + \frac{ \|x_{t-1}-\sqrt{\bar\alpha_{t-1}}x_0\|^2 }{ 1-\bar\alpha_{t-1} } \right) \right]. \end{aligned}

这一步重新使用了 βt=1−αt\beta_t=1-\alpha_t

为了更容易看出配方结构,暂时令:

y=xt−1.y=x_{t-1}.

只保留指数中与 yy 有关的项并展开:

∥xt−αty∥2βt+∥y−αˉt−1x0∥21−αˉt−1=(αtβt+11−αˉt−1)∥y∥2−2(αtβtxt+αˉt−11−αˉt−1x0)Ty+C,\begin{aligned} &\frac{\|x_t-\sqrt{\alpha_t}y\|^2}{\beta_t} + \frac{ \|y-\sqrt{\bar\alpha_{t-1}}x_0\|^2 }{ 1-\bar\alpha_{t-1} }\\ ={}& \left( \frac{\alpha_t}{\beta_t} + \frac{1}{1-\bar\alpha_{t-1}} \right)\|y\|^2\\ &- 2 \left( \frac{\sqrt{\alpha_t}}{\beta_t}x_t + \frac{ \sqrt{\bar\alpha_{t-1}} }{ 1-\bar\alpha_{t-1} }x_0 \right)^\mathsf T y + C, \end{aligned}

其中 CC 收集所有与 yy 无关的项。

定义二次项系数:

A=αtβt+11−αˉt−1.A = \frac{\alpha_t}{\beta_t} + \frac{1}{1-\bar\alpha_{t-1}}.

利用:

βt=1−αt,αˉt=αtαˉt−1,\beta_t=1-\alpha_t, \qquad \bar\alpha_t=\alpha_t\bar\alpha_{t-1},

可以化简:

A=αt(1−αˉt−1)+βtβt(1−αˉt−1)=1−αtαˉt−1βt(1−αˉt−1)=1−αˉtβt(1−αˉt−1).\begin{aligned} A &= \frac{ \alpha_t(1-\bar\alpha_{t-1})+\beta_t }{ \beta_t(1-\bar\alpha_{t-1}) }\\ &= \frac{ 1-\alpha_t\bar\alpha_{t-1} }{ \beta_t(1-\bar\alpha_{t-1}) }\\ &= \frac{ 1-\bar\alpha_t }{ \beta_t(1-\bar\alpha_{t-1}) }. \end{aligned}

高斯分布指数中的二次项系数是协方差的逆,因此:

β~t=A−1=βt(1−αˉt−1)1−αˉt.\tilde\beta_t=A^{-1} = \frac{ \beta_t(1-\bar\alpha_{t-1}) }{ 1-\bar\alpha_t }.

再定义线性项中的向量:

b=αtβtxt+αˉt−11−αˉt−1x0.b = \frac{\sqrt{\alpha_t}}{\beta_t}x_t + \frac{ \sqrt{\bar\alpha_{t-1}} }{ 1-\bar\alpha_{t-1} }x_0.

对 A∥y∥2−2bTyA\|y\|^2-2b^\mathsf T y 配方:

A∥y∥2−2bTy=A∥y−A−1b∥2−A−1∥b∥2.A\|y\|^2-2b^\mathsf T y = A\|y-A^{-1}b\|^2 - A^{-1}\|b\|^2.

因此高斯均值是:

μ~t=A−1b=β~tb.\tilde\mu_t=A^{-1}b=\tilde\beta_t b.

分别整理 x0x_0 和 xtx_t 的系数:

μ~t(xt,x0)=αˉt−1βt1−αˉtx0+αt(1−αˉt−1)1−αˉtxt.\begin{aligned} \tilde\mu_t(x_t,x_0) ={}& \frac{ \sqrt{\bar\alpha_{t-1}}\beta_t }{ 1-\bar\alpha_t }x_0\\ &+ \frac{ \sqrt{\alpha_t}(1-\bar\alpha_{t-1}) }{ 1-\bar\alpha_t }x_t. \end{aligned}

于是完成计算:

q(xt−1∣xt,x0)=N(xt−1;μ~t(xt,x0),β~tI).q(x_{t-1}\mid x_t,x_0) = \mathcal N \left( x_{t-1}; \tilde\mu_t(x_t,x_0), \tilde\beta_t I \right).

4.4 继续消去 x0x_0​

上面的真实后验均值仍然含有 x0x_0。训练时 x0x_0 已知,但生成时只有 xtx_t,所以还要利用:

xt=αˉtx0+1−αˉt ϵx_t = \sqrt{\bar\alpha_t}x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon

消去 x0x_0。直接代换后的答案是:

μ~t=1αt(xt−βt1−αˉtϵ).\tilde\mu_t = \frac{1}{\sqrt{\alpha_t}} \left( x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon \right).
展开计算

先从前向采样公式反解 x0x_0:

x0=xt−1−αˉt ϵαˉt.x_0 = \frac{ x_t-\sqrt{1-\bar\alpha_t}\,\epsilon }{ \sqrt{\bar\alpha_t} }.

把它代入刚刚求出的真实后验均值:

μ~t=αˉt−1βt1−αˉtxt−1−αˉt ϵαˉt+αt(1−αˉt−1)1−αˉtxt.\begin{aligned} \tilde\mu_t ={}& \frac{ \sqrt{\bar\alpha_{t-1}}\beta_t }{ 1-\bar\alpha_t } \frac{ x_t-\sqrt{1-\bar\alpha_t}\,\epsilon }{ \sqrt{\bar\alpha_t} }\\ &+ \frac{ \sqrt{\alpha_t}(1-\bar\alpha_{t-1}) }{ 1-\bar\alpha_t }x_t. \end{aligned}

因为:

αˉt=αtαˉt−1,αˉt−1αˉt=1αt,\bar\alpha_t=\alpha_t\bar\alpha_{t-1}, \qquad \frac{\sqrt{\bar\alpha_{t-1}}}{\sqrt{\bar\alpha_t}} = \frac{1}{\sqrt{\alpha_t}},

所以:

μ~t=βtαt(1−αˉt)xt−βtαt1−αˉtϵ+αt(1−αˉt−1)1−αˉtxt.\begin{aligned} \tilde\mu_t ={}& \frac{\beta_t} {\sqrt{\alpha_t}(1-\bar\alpha_t)}x_t - \frac{\beta_t} {\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}}\epsilon\\ &+ \frac{ \sqrt{\alpha_t}(1-\bar\alpha_{t-1}) }{ 1-\bar\alpha_t }x_t. \end{aligned}

合并两个 xtx_t 项:

μ~t=βt+αt(1−αˉt−1)αt(1−αˉt)xt−βtαt1−αˉtϵ.\begin{aligned} \tilde\mu_t ={}& \frac{ \beta_t+\alpha_t(1-\bar\alpha_{t-1}) }{ \sqrt{\alpha_t}(1-\bar\alpha_t) }x_t\\ &- \frac{\beta_t} {\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}}\epsilon. \end{aligned}

利用:

βt+αt(1−αˉt−1)=1−αt+αt−αtαˉt−1=1−αˉt,\begin{aligned} \beta_t+\alpha_t(1-\bar\alpha_{t-1}) &= 1-\alpha_t+\alpha_t-\alpha_t\bar\alpha_{t-1}\\ &= 1-\bar\alpha_t, \end{aligned}

得到:

μ~t=1αtxt−βtαt1−αˉtϵ=1αt(xt−βt1−αˉtϵ).\begin{aligned} \tilde\mu_t &= \frac{1}{\sqrt{\alpha_t}}x_t - \frac{\beta_t} {\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}}\epsilon\\ &= \frac{1}{\sqrt{\alpha_t}} \left( x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon \right). \end{aligned}

这个结果不再显式依赖 x0x_0。只要模型能够从 xtx_t 预测累计噪声 ϵ\epsilon,就能得到反向分布的均值。

这个结果后面也会用到

5. 从极大似然推导​

到目前为止,我们已经知道怎样构造训练样本:

xt=αˉtx0+1−αˉtϵ,x_t = \sqrt{\bar\alpha_t}x_0 + \sqrt{1-\bar\alpha_t}\epsilon,

也知道只要让网络预测这份噪声:

ϵθ(xt,t)≈ϵ,\epsilon_\theta(x_t,t)\approx\epsilon,

就能够构造反向均值并训练模型。因此,从实现角度看,“预测噪声 + 对噪声做MSE损失”已经足够写出训练代码。

但是仍然需要回答一个理论问题:

为什么最小化噪声预测 MSE,会让生成分布 pθ(x0)p_\theta(x_0) 接近真实数据分布?

答案是:它可以从最大似然的变分下界推导出来。不过要注意,原始 DDPM 实际使用的无权重 LsimpleL_{\mathrm{simple}} 是对严格变分下界目标的进一步简化,并不与负对数似然逐项完全相等。

5.1 最大似然最终变成什么目标​

完整的最大似然目标需要对真实数据分布中的图片取期望:

max⁡θEx0∼pdata[log⁡pθ(x0)].\max_\theta \mathbb E_{x_0\sim p_{\mathrm{data}}} \left[ \log p_\theta(x_0) \right].

真实分布 pdatap_{\mathrm{data}} 没有解析表达式,我们只有包含 NN 张图片的训练集,所以使用数据集均值近似:

max⁡θ1N∑n=1Nlog⁡pθ ⁣(x0(n)).\max_\theta \frac{1}{N} \sum_{n=1}^{N} \log p_\theta\!\left(x_0^{(n)}\right).

实际使用大小为 BB 的 mini-batch 训练时,再用 batch 均值作为这个期望的随机估计:

1B∑b=1Blog⁡pθ ⁣(x0(b)).\frac{1}{B} \sum_{b=1}^{B} \log p_\theta\!\left(x_0^{(b)}\right).

下面和 VAE 的推导一样,为了简化符号,先固定其中一张训练图片 x0x_0,推导它的单样本目标:

log⁡pθ(x0).\log p_\theta(x_0).

推导完成后,还要在最外层对 x0∼pdatax_0\sim p_{\mathrm{data}} 取期望。因此后文只写 log⁡pθ(x0)\log p_\theta(x_0),并不表示训练时只使用一张图片。


中间变量 x1,…,xTx_1,\ldots,x_T 没有被观测,所以:

pθ(x0)=∫pθ(x0:T) dx1:Tp_\theta(x_0) = \int p_\theta(x_{0:T}) \,dx_{1:T}

无法直接计算。下面不是直接“写出”ELBO,而是一步一步把不可计算的积分改造成可以采样估计的期望。

首先,我们已经知道如何从干净图片 x0x_0 采样整条前向噪声链,因此有:

q(x1:T∣x0)=∏t=1Tq(xt∣xt−1).q(x_{1:T}\mid x_0) = \prod_{t=1}^{T} q(x_t\mid x_{t-1}).

这是一个合法的条件概率分布,所以:

∫q(x1:T∣x0) dx1:T=1.\int q(x_{1:T}\mid x_0)\,dx_{1:T}=1.

在 pθ(x0)p_\theta(x_0) 的积分中同时乘上和除以这个分布,积分值不会改变:

pθ(x0)=∫pθ(x0:T) dx1:T=∫q(x1:T∣x0)pθ(x0:T)q(x1:T∣x0) dx1:T.\begin{aligned} p_\theta(x_0) &= \int p_\theta(x_{0:T}) \,dx_{1:T}\\ &= \int q(x_{1:T}\mid x_0) \frac{ p_\theta(x_{0:T}) }{ q(x_{1:T}\mid x_0) } \,dx_{1:T}. \end{aligned}

根据期望的定义:

Ez∼q(z)[f(z)]=∫q(z)f(z) dz,\mathbb E_{z\sim q(z)}[f(z)] = \int q(z)f(z)\,dz,

所以上面的积分可以写成:

pθ(x0)=Eq(x1:T∣x0)[pθ(x0:T)q(x1:T∣x0)].p_\theta(x_0) = \mathbb E_{q(x_{1:T}\mid x_0)} \left[ \frac{ p_\theta(x_{0:T}) }{ q(x_{1:T}\mid x_0) } \right].

这一步仍然是严格等式。两边取对数:

log⁡pθ(x0)=log⁡Eq(x1:T∣x0)[pθ(x0:T)q(x1:T∣x0)].\log p_\theta(x_0) = \log \mathbb E_{q(x_{1:T}\mid x_0)} \left[ \frac{ p_\theta(x_{0:T}) }{ q(x_{1:T}\mid x_0) } \right].

问题在于对数位于期望外面,这个量仍然不方便直接优化。由于 log⁡\log 是凹函数,Jensen 不等式给出:

log⁡E[Y]≥E[log⁡Y].\log\mathbb E[Y] \ge \mathbb E[\log Y].

令:

Y=pθ(x0:T)q(x1:T∣x0),Y = \frac{ p_\theta(x_{0:T}) }{ q(x_{1:T}\mid x_0) },

便得到:

log⁡pθ(x0)≥Eq(x1:T∣x0)[log⁡pθ(x0:T)q(x1:T∣x0)]:=LELBO(x0).\begin{aligned} \log p_\theta(x_0) &\ge \mathbb E_{q(x_{1:T}\mid x_0)} \left[ \log \frac{ p_\theta(x_{0:T}) }{ q(x_{1:T}\mid x_0) } \right]\\ &:= \mathcal L_{\mathrm{ELBO}}(x_0). \end{aligned}

符号 :=:= 表示把右边这个期望定义为 LELBO(x0)\mathcal L_{\mathrm{ELBO}}(x_0)。因为它不超过 log⁡pθ(x0)\log p_\theta(x_0),所以称为“证据下界”。

这个下界与真实对数似然之间究竟差多少,也可以精确写出。模型的真实后验为:

pθ(x1:T∣x0)=pθ(x0:T)pθ(x0).p_\theta(x_{1:T}\mid x_0) = \frac{ p_\theta(x_{0:T}) }{ p_\theta(x_0) }.

计算前向分布与该真实后验之间的 KL:

DKL(q(x1:T∣x0)∥pθ(x1:T∣x0))=Eq(x1:T∣x0)[log⁡q(x1:T∣x0)pθ(x1:T∣x0)]=Eq(x1:T∣x0)[log⁡q(x1:T∣x0)pθ(x0)pθ(x0:T)]=log⁡pθ(x0)−Eq(x1:T∣x0)[log⁡pθ(x0:T)q(x1:T∣x0)]=log⁡pθ(x0)−LELBO(x0).\begin{aligned} &D_{\mathrm{KL}} \left( q(x_{1:T}\mid x_0) \| p_\theta(x_{1:T}\mid x_0) \right)\\ &= \mathbb E_{q(x_{1:T}\mid x_0)} \left[ \log \frac{ q(x_{1:T}\mid x_0) }{ p_\theta(x_{1:T}\mid x_0) } \right]\\ &= \mathbb E_{q(x_{1:T}\mid x_0)} \left[ \log \frac{ q(x_{1:T}\mid x_0)p_\theta(x_0) }{ p_\theta(x_{0:T}) } \right]\\ &= \log p_\theta(x_0) - \mathbb E_{q(x_{1:T}\mid x_0)} \left[ \log \frac{ p_\theta(x_{0:T}) }{ q(x_{1:T}\mid x_0) } \right]\\ &= \log p_\theta(x_0) - \mathcal L_{\mathrm{ELBO}}(x_0). \end{aligned}

因此有精确恒等式:

log⁡pθ(x0)=LELBO(x0)+DKL(q(x1:T∣x0)∥pθ(x1:T∣x0)).\log p_\theta(x_0) = \mathcal L_{\mathrm{ELBO}}(x_0) + D_{\mathrm{KL}} \left( q(x_{1:T}\mid x_0) \| p_\theta(x_{1:T}\mid x_0) \right).

KL 散度始终非负,所以 ELBO 必然是下界;当 q(x1:T∣x0)q(x_{1:T}\mid x_0) 与模型真实后验完全一致时,KL 为零,ELBO 才会等于真实对数似然。

将它整理后,最终结果为:

LELBO(x0)=Eq(x1∣x0)[log⁡pθ(x0∣x1)]⏟重建项−DKL(q(xT∣x0)∥p(xT))⏟先验匹配项−∑t=2TEq(xt∣x0)[DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))]⏟逐步去噪匹配项.\begin{aligned} \mathcal L_{\mathrm{ELBO}}(x_0) ={}& \underbrace{ \mathbb E_{q(x_1\mid x_0)} [\log p_\theta(x_0\mid x_1)] }_{\text{重建项}}\\ &- \underbrace{ D_{\mathrm{KL}} \left( q(x_T\mid x_0)\|p(x_T) \right) }_{\text{先验匹配项}}\\ &- \underbrace{ \sum_{t=2}^{T} \mathbb E_{q(x_t\mid x_0)} \left[ D_{\mathrm{KL}} \left( q(x_{t-1}\mid x_t,x_0) \| p_\theta(x_{t-1}\mid x_t) \right) \right] }_{\text{逐步去噪匹配项}}. \end{aligned}

最大化 ELBO 等价于最小化它的相反数:

LVLB=L0+∑t=2TLt−1+LT.\mathcal L_{\mathrm{VLB}} = L_0+\sum_{t=2}^{T}L_{t-1}+L_T.

三个部分分别表示:

  • L0=−E[log⁡pθ(x0∣x1)]L_0=-\mathbb E[\log p_\theta(x_0\mid x_1)]:最后一步从 x1x_1 恢复 x0x_0;
  • LT=DKL(q(xT∣x0)∥p(xT))L_T=D_{\mathrm{KL}}(q(x_T\mid x_0)\|p(x_T)):让前向终点接近生成起点 N(0,I)\mathcal N(0,I);
  • Lt−1L_{t-1}:让模型的反向一步逼近可计算的真实后验。
展开推导:从最大似然到三个 ELBO 项(对应官方式 47–58)

为缩短后面的公式,记:

Eq[⋅]:=Eq(x1:T∣x0)[⋅].\mathbb E_q[\cdot] := \mathbb E_{q(x_{1:T}\mid x_0)}[\cdot].

首先把边缘似然写成对中间变量的积分:

log⁡pθ(x0)=log⁡∫pθ(x0:T) dx1:T=log⁡∫q(x1:T∣x0)pθ(x0:T)q(x1:T∣x0) dx1:T=log⁡Eq(x1:T∣x0)[pθ(x0:T)q(x1:T∣x0)].\begin{aligned} \log p_\theta(x_0) &= \log \int p_\theta(x_{0:T}) \,dx_{1:T}\\ &= \log \int q(x_{1:T}\mid x_0) \frac{ p_\theta(x_{0:T}) }{ q(x_{1:T}\mid x_0) } \,dx_{1:T}\\ &= \log \mathbb E_{q(x_{1:T}\mid x_0)} \left[ \frac{ p_\theta(x_{0:T}) }{ q(x_{1:T}\mid x_0) } \right]. \end{aligned}

由于 log⁡\log 是凹函数,根据 Jensen 不等式:

log⁡E[Y]≥E[log⁡Y].\log\mathbb E[Y] \ge \mathbb E[\log Y].

所以:

log⁡pθ(x0)≥Eq(x1:T∣x0)[log⁡pθ(x0:T)q(x1:T∣x0)].\log p_\theta(x_0) \ge \mathbb E_{q(x_{1:T}\mid x_0)} \left[ \log \frac{ p_\theta(x_{0:T}) }{ q(x_{1:T}\mid x_0) } \right].

这就是官方式 (47)。接下来展开生成链和前向链:

pθ(x0:T)=p(xT)∏t=1Tpθ(xt−1∣xt),p_\theta(x_{0:T}) = p(x_T) \prod_{t=1}^{T} p_\theta(x_{t-1}\mid x_t),q(x1:T∣x0)=∏t=1Tq(xt∣xt−1).q(x_{1:T}\mid x_0) = \prod_{t=1}^{T} q(x_t\mid x_{t-1}).

代入:

LELBO=Eq[log⁡p(xT)∏t=1Tpθ(xt−1∣xt)∏t=1Tq(xt∣xt−1)].\mathcal L_{\mathrm{ELBO}} = \mathbb E_q \left[ \log \frac{ p(x_T) \prod_{t=1}^{T}p_\theta(x_{t-1}\mid x_t) }{ \prod_{t=1}^{T}q(x_t\mid x_{t-1}) } \right].

把 t=1t=1 的项单独取出:

LELBO=Eq[log⁡p(xT)pθ(x0∣x1)∏t=2Tpθ(xt−1∣xt)q(x1∣x0)∏t=2Tq(xt∣xt−1)].\mathcal L_{\mathrm{ELBO}} = \mathbb E_q \left[ \log \frac{ p(x_T)p_\theta(x_0\mid x_1) \prod_{t=2}^{T}p_\theta(x_{t-1}\mid x_t) }{ q(x_1\mid x_0) \prod_{t=2}^{T}q(x_t\mid x_{t-1}) } \right].

由于前向过程满足马尔可夫性:

q(xt∣xt−1)=q(xt∣xt−1,x0).q(x_t\mid x_{t-1}) = q(x_t\mid x_{t-1},x_0).

对 t≥2t\ge2,根据 Bayes 公式:

q(xt−1∣xt,x0)=q(xt∣xt−1,x0)q(xt−1∣x0)q(xt∣x0).q(x_{t-1}\mid x_t,x_0) = \frac{ q(x_t\mid x_{t-1},x_0) q(x_{t-1}\mid x_0) }{ q(x_t\mid x_0) }.

移项得到:

1q(xt∣xt−1,x0)=q(xt−1∣x0)q(xt−1∣xt,x0)q(xt∣x0).\frac{1}{ q(x_t\mid x_{t-1},x_0) } = \frac{ q(x_{t-1}\mid x_0) }{ q(x_{t-1}\mid x_t,x_0) q(x_t\mid x_0) }.

因此,前向分布乘积的倒数可以改写为:

1q(x1∣x0)∏t=2Tq(xt∣xt−1,x0)=1q(x1∣x0)∏t=2Tq(xt−1∣x0)q(xt−1∣xt,x0)q(xt∣x0).\begin{aligned} &\frac{1}{ q(x_1\mid x_0) \prod_{t=2}^{T}q(x_t\mid x_{t-1},x_0) }\\ &= \frac{1}{q(x_1\mid x_0)} \prod_{t=2}^{T} \frac{ q(x_{t-1}\mid x_0) }{ q(x_{t-1}\mid x_t,x_0) q(x_t\mid x_0) }. \end{aligned}

把只含边缘分布的部分单独观察:

1q(x1∣x0)∏t=2Tq(xt−1∣x0)q(xt∣x0).\frac{1}{q(x_1\mid x_0)} \prod_{t=2}^{T} \frac{ q(x_{t-1}\mid x_0) }{ q(x_t\mid x_0) }.

将乘积展开:

1q(x1∣x0)q(x1∣x0)q(x2∣x0)q(x2∣x0)q(x3∣x0)⋯q(xT−1∣x0)q(xT∣x0).\frac{1}{q(x_1\mid x_0)} \frac{q(x_1\mid x_0)}{q(x_2\mid x_0)} \frac{q(x_2\mid x_0)}{q(x_3\mid x_0)} \cdots \frac{q(x_{T-1}\mid x_0)}{q(x_T\mid x_0)}.

相邻的分子分母全部抵消,最终只剩:

1q(xT∣x0).\frac{1}{q(x_T\mid x_0)}.

所以 ELBO 可以整理为:

LELBO=Eq[log⁡p(xT)pθ(x0∣x1)q(xT∣x0)+log⁡∏t=2Tpθ(xt−1∣xt)q(xt−1∣xt,x0)].\mathcal L_{\mathrm{ELBO}} = \mathbb E_q \left[ \log \frac{ p(x_T)p_\theta(x_0\mid x_1) }{ q(x_T\mid x_0) } + \log \prod_{t=2}^{T} \frac{ p_\theta(x_{t-1}\mid x_t) }{ q(x_{t-1}\mid x_t,x_0) } \right].

使用 log⁡∏tat=∑tlog⁡at\log\prod_t a_t=\sum_t\log a_t:

LELBO=Eq[log⁡pθ(x0∣x1)]+Eq[log⁡p(xT)q(xT∣x0)]+∑t=2TEq[log⁡pθ(xt−1∣xt)q(xt−1∣xt,x0)].\begin{aligned} \mathcal L_{\mathrm{ELBO}} ={}& \mathbb E_q[\log p_\theta(x_0\mid x_1)]\\ &+ \mathbb E_q \left[ \log \frac{p(x_T)}{q(x_T\mid x_0)} \right]\\ &+ \sum_{t=2}^{T} \mathbb E_q \left[ \log \frac{ p_\theta(x_{t-1}\mid x_t) }{ q(x_{t-1}\mid x_t,x_0) } \right]. \end{aligned}

根据 KL 散度定义:

DKL(q∥p)=Eq[log⁡qp],D_{\mathrm{KL}}(q\|p) = \mathbb E_q \left[ \log\frac{q}{p} \right],

所以:

Eq[log⁡pq]=−DKL(q∥p).\mathbb E_q \left[ \log\frac{p}{q} \right] = -D_{\mathrm{KL}}(q\|p).

分别应用到第二项和第三项:

LELBO=Eq(x1∣x0)[log⁡pθ(x0∣x1)]−DKL(q(xT∣x0)∥p(xT))−∑t=2TEq(xt∣x0)[DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))].\begin{aligned} \mathcal L_{\mathrm{ELBO}} ={}& \mathbb E_{q(x_1\mid x_0)} [\log p_\theta(x_0\mid x_1)]\\ &- D_{\mathrm{KL}} \left( q(x_T\mid x_0)\|p(x_T) \right)\\ &- \sum_{t=2}^{T} \mathbb E_{q(x_t\mid x_0)} \left[ D_{\mathrm{KL}} \left( q(x_{t-1}\mid x_t,x_0) \| p_\theta(x_{t-1}\mid x_t) \right) \right]. \end{aligned}

这就是官方式 (58)。

5.2 去噪 KL 为什么会变成噪声 MSE​

对 t≥2t\ge2,真实后验和模型反向分布都是高斯:

q(xt−1∣xt,x0)=N(xt−1;μ~t,β~tI),q(x_{t-1}\mid x_t,x_0) = \mathcal N \left( x_{t-1}; \tilde\mu_t, \tilde\beta_t I \right), pθ(xt−1∣xt)=N(xt−1;μθ,σt2I).p_\theta(x_{t-1}\mid x_t) = \mathcal N \left( x_{t-1}; \mu_\theta, \sigma_t^2 I \right).

如果 σt2\sigma_t^2 预先固定,那么去噪 KL 中与模型参数 θ\theta 有关的部分是:

Lt−1=E[12σt2∥μ~t−μθ∥2]+C.L_{t-1} = \mathbb E \left[ \frac{1}{2\sigma_t^2} \| \tilde\mu_t-\mu_\theta \|^2 \right] + C.

把真实噪声 ϵ\epsilon 和预测噪声 ϵθ\epsilon_\theta 的均值参数化代入后:

Lt−1=Ex0,ϵ[βt22σt2αt(1−αˉt)∥ϵ−ϵθ(xt,t)∥2]+C.L_{t-1} = \mathbb E_{x_0,\epsilon} \left[ \frac{\beta_t^2} {2\sigma_t^2\alpha_t(1-\bar\alpha_t)} \| \epsilon-\epsilon_\theta(x_t,t) \|^2 \right] + C.

这就是从最大似然严格推导出来的带权噪声 MSE。

展开计算:从两个高斯的 KL 到带权噪声 MSE

先从两个一般的 dd 维高斯分布开始:

q=N(μq,Σq),p=N(μp,Σp).q=\mathcal N(\mu_q,\Sigma_q), \qquad p=\mathcal N(\mu_p,\Sigma_p).

它们的 KL 散度为:

DKL(q∥p)=12[tr⁡(Σp−1Σq)+(μp−μq)TΣp−1(μp−μq)−d+log⁡det⁡Σpdet⁡Σq].\begin{aligned} D_{\mathrm{KL}}(q\|p) = \frac{1}{2}\Big[ &\operatorname{tr}(\Sigma_p^{-1}\Sigma_q) + (\mu_p-\mu_q)^\mathsf T \Sigma_p^{-1} (\mu_p-\mu_q)\\ &-d + \log \frac{\det\Sigma_p}{\det\Sigma_q} \Big]. \end{aligned}

在 DDPM 的第 tt 个反向步骤中:

μq=μ~t,Σq=β~tI,μp=μθ,Σp=σt2I.\mu_q=\tilde\mu_t, \qquad \Sigma_q=\tilde\beta_tI, \qquad \mu_p=\mu_\theta, \qquad \Sigma_p=\sigma_t^2I.

因此:

Σp−1=1σt2I,\Sigma_p^{-1} = \frac{1}{\sigma_t^2}I,tr⁡(Σp−1Σq)=dβ~tσt2,\operatorname{tr}(\Sigma_p^{-1}\Sigma_q) = d\frac{\tilde\beta_t}{\sigma_t^2},log⁡det⁡Σpdet⁡Σq=dlog⁡σt2β~t,\log \frac{\det\Sigma_p}{\det\Sigma_q} = d\log\frac{\sigma_t^2}{\tilde\beta_t},

并且:

(μθ−μ~t)TΣp−1(μθ−μ~t)=1σt2∥μ~t−μθ∥2.(\mu_\theta-\tilde\mu_t)^\mathsf T \Sigma_p^{-1} (\mu_\theta-\tilde\mu_t) = \frac{1}{\sigma_t^2} \|\tilde\mu_t-\mu_\theta\|^2.

全部代回:

DKL(N(μ~t,β~tI)∥N(μθ,σt2I))=12[dβ~tσt2+1σt2∥μ~t−μθ∥2−d+dlog⁡σt2β~t].\begin{aligned} &D_{\mathrm{KL}} \left( \mathcal N(\tilde\mu_t,\tilde\beta_tI) \| \mathcal N(\mu_\theta,\sigma_t^2I) \right)\\ &= \frac{1}{2} \left[ d\frac{\tilde\beta_t}{\sigma_t^2} + \frac{1}{\sigma_t^2} \|\tilde\mu_t-\mu_\theta\|^2 -d + d\log\frac{\sigma_t^2}{\tilde\beta_t} \right]. \end{aligned}

当 β~t\tilde\beta_t 和 σt2\sigma_t^2 都预先固定时,只有均值误差依赖模型参数 θ\theta。把其余项合并为常数 CC:

DKL(N(μ~t,β~tI)∥N(μθ,σt2I))=12σt2∥μ~t−μθ∥2+C.D_{\mathrm{KL}} \left( \mathcal N(\tilde\mu_t,\tilde\beta_tI) \| \mathcal N(\mu_\theta,\sigma_t^2I) \right) = \frac{1}{2\sigma_t^2} \|\tilde\mu_t-\mu_\theta\|^2 + C.

CC 包含方差、维度和对数行列式等与 θ\theta 无关的项。

前面已经得到真实后验均值:

μ~t=1αt(xt−βt1−αˉtϵ).\tilde\mu_t = \frac{1}{\sqrt{\alpha_t}} \left( x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}} \epsilon \right).

模型均值使用相同形式,但把真实噪声替换成网络预测:

μθ=1αt(xt−βt1−αˉtϵθ(xt,t)).\mu_\theta = \frac{1}{\sqrt{\alpha_t}} \left( x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}} \epsilon_\theta(x_t,t) \right).

两者相减,xtx_t 项抵消:

μ~t−μθ=βtαt1−αˉt(ϵθ(xt,t)−ϵ).\begin{aligned} \tilde\mu_t-\mu_\theta &= \frac{\beta_t} {\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}} \left( \epsilon_\theta(x_t,t)-\epsilon \right). \end{aligned}

平方后:

∥μ~t−μθ∥2=βt2αt(1−αˉt)∥ϵ−ϵθ(xt,t)∥2.\| \tilde\mu_t-\mu_\theta \|^2 = \frac{\beta_t^2} {\alpha_t(1-\bar\alpha_t)} \| \epsilon-\epsilon_\theta(x_t,t) \|^2.

代回高斯 KL:

Lt−1=E[βt22σt2αt(1−αˉt)∥ϵ−ϵθ(xt,t)∥2]+C.L_{t-1} = \mathbb E \left[ \frac{\beta_t^2} {2\sigma_t^2\alpha_t(1-\bar\alpha_t)} \| \epsilon-\epsilon_\theta(x_t,t) \|^2 \right] + C.

5.3 为什么实际训练只使用普通 MSE​

严格变分目标中的每个时间步带有权重:

wt=βt22σt2αt(1−αˉt).w_t = \frac{\beta_t^2} {2\sigma_t^2\alpha_t(1-\bar\alpha_t)}.

原始 DDPM 发现,去掉这个权重通常能够获得更好的生成质量,于是定义简化目标:

Lsimple=Ex0∼pdata,t∼Uniform{1,…,T},ϵ∼N(0,I)[∥ϵ−ϵθ(xt,t)∥22].L_{\mathrm{simple}} = \mathbb E_{ x_0\sim p_{\mathrm{data}}, t\sim\mathrm{Uniform}\{1,\ldots,T\}, \epsilon\sim\mathcal N(0,I) } \left[ \| \epsilon-\epsilon_\theta(x_t,t) \|_2^2 \right].

其中:

xt=αˉtx0+1−αˉtϵ.x_t = \sqrt{\bar\alpha_t}x_0 + \sqrt{1-\bar\alpha_t}\epsilon.

因此,最准确的结论是:

  1. 从实现角度:现在的信息确实已经足够训练;随机选择 tt、构造 xtx_t、预测 ϵ\epsilon 并计算 MSE 即可。
  2. 从理论角度:最大似然经过 ELBO、高斯 KL 和噪声参数化,可以严格推出带权噪声 MSE。
  3. 从原始 DDPM 的实际做法看:常用的无权重 LsimpleL_{\mathrm{simple}} 删除了理论权重,是与变分目标密切相关但经过经验简化的代理目标。

6. 训练与生成​

6.1 训练​

每次训练先采样一张真实图片、一个时间步和一份标准高斯噪声:

x0∼pdata,t∼Uniform⁡{1,…,T},ϵ∼N(0,I).x_0\sim p_{\mathrm{data}}, \qquad t\sim\operatorname{Uniform}\{1,\ldots,T\}, \qquad \epsilon\sim\mathcal N(0,I).

利用前向过程的闭式公式,直接构造所抽取时间步的带噪图片:

xt=αˉtx0+1−αˉtϵ.x_t = \sqrt{\bar\alpha_t}x_0 + \sqrt{1-\bar\alpha_t}\epsilon.

网络根据带噪图片和时间步预测噪声:

ϵ^=ϵθ(xt,t).\hat\epsilon = \epsilon_\theta(x_t,t).

使用简化的噪声预测损失:

Lsimple=∥ϵ−ϵθ(xt,t)∥22.L_{\mathrm{simple}} = \left\| \epsilon-\epsilon_\theta(x_t,t) \right\|_2^2.

然后对损失反向传播并更新模型参数:

θ←θ−η∇θLsimple,\theta \leftarrow \theta-\eta\nabla_\theta L_{\mathrm{simple}},

其中 eta 是优化器当前使用的学习率。

训练过程中不需要按顺序构造整条前向链:

x0→x1→⋯→xt.x_0\to x_1\to\cdots\to x_t.

因为任意时间步的带噪状态都能由干净图片一步采样得到。

6.2 生成​

训练完成后,首先从标准高斯先验中采样:

xT∼N(0,I).x_T\sim\mathcal N(0,I).

然后按照:

t=T,T−1,…,1t=T,T-1,\ldots,1

依次执行反向去噪。每一步使用的随机噪声为:

z∼{N(0,I),t>1,δ(0),t=1,z\sim \begin{cases} \mathcal N(0,I), & t>1,\\ \delta(0), & t=1, \end{cases}

其中 delta(0) 表示集中在零点的退化分布;也就是说,在最后一个时间步直接令噪声为零。

反向采样公式为:

xt−1=1αt(xt−βt1−αˉtϵθ(xt,t))+σtz.x_{t-1} = \frac{1}{\sqrt{\alpha_t}} \left( x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}} \epsilon_\theta(x_t,t) \right) + \sigma_t z.

这里 σtz\sigma_t z 引入随机性,实验证明能提高生成质量

基础 DDPM 可以将反向方差设置为:

σt2=β~t=1−αˉt−11−αˉtβt.\sigma_t^2 = \tilde\beta_t = \frac{1-\bar\alpha_{t-1}} {1-\bar\alpha_t}\beta_t.

执行到最后一步后得到生成结果:

x0x_0